从 PRD 到 Specs:编码自动化之后,需求成了新的瓶颈
返回博客列表
这篇文章想聊清楚三件事:
- 为什么编码自动化之后,卡点从开发挪到了需求;
- 为什么以 OpenSpec 为代表的传统 SDD,只解决了产品流程的「最内环」;
- 怎么用一套可以按团队轻重分型的脚手架,把 SDD 扩展到产品端到端,让外环也走到 L3。
如果只看交付看板,团队今年的变化其实非常直观。
过去我们盯的是需求 Backlog:产品经理手里排着几十条需求,开发同学忙不过来。现在再看同一块看板,压力位明显往左挪了——Idea 和评估中那一栏堆着还没想清楚的业务机会,需求分析中的格子也被填满,反倒是「开发中」经常只有零星几个任务。
前段时间在 AiDD 成都站,我以《从 PRD 到 Specs:AI 重塑需求工程》为题做了分享。整场分享的起点,就是上面这个反直觉的现场观察:编码被 AI 大幅加速之后,交付真正的瓶颈,正在从写代码那一段往上游转移。
这个判断有一个前提——团队已经真正把 AI 用进了编码环节。如果 AI 编码还没落地,瓶颈大概率仍留在实现侧。下文讨论的,是前一种情况。
🧱 一、新现实:过去是「需求等开发」,现在是「开发等需求」
把两张典型交付看板并排放在一起,问题会很清楚。
| 看板列 | 过去:「需求」等开发 | 现在:开发等「需求」 |
|---|---|---|
| 需求 Backlog | 52(促销活动、会员体系、报表性能…) | — |
| Idea / 评估中 | — | 8(AI 客户服务助手、供应链优化方案…) |
| 需求分析中 | — | 12(业务方案分析、需求澄清、可行性评估…) |
| 设计中 | 8 | 12 |
| 开发中 | 15 | 6(少量) |
| 测试中 | 8 | 4 |
| 已上线 | 8 | 3 |
过去的主要矛盾是「需求多、变更频繁、交付压力大」,需求 Backlog 积压严重;现在的主要矛盾变成了「业务 idea 还没分析完、没到 Ready 状态,开发在等需求」。
这背后是一个正在发生的结构性变化:大模型显著抬高了实现吞吐的上限——代码生成、样板搭建、重构迁移都比以前快。当写代码这段路被拓宽之后,原本被它掩盖的上游问题就暴露出来了:需求不可验证、变更不可控、影响不可追溯。
一句话概括:稀缺的不再是「把东西写出来」,而是可追溯、可测试、可审计的需求定义与验收口径。
需求到底为什么慢?在分享里我把它拆成了五个维度,而这五个维度往往需要一起发力才有效。
| 维度 | 现状 | 破局方向 |
|---|---|---|
| 工具 | 缺少像 Codex 一样趁手的需求 Agent | 在需求端提供一套「OpenSpec」,让 AI 承接操作型任务,人只做核心判断 |
| 流程 | 流程长、传统且固化,未达标就不能进开发 | 允许不同域的产品团队采用不同流程,先让更多团队轻量运转起来 |
| 组织 | 业务与 IT 割裂,角色之间来回传递 | 尽可能让割裂的角色融合为一个角色,缩短沟通链路 |
| 知识 | 需求治理长期缺位,过往文档参考价值低 | 借鉴 OpenSpec /archive 的机制,让 AI 把知识沉淀出来,取代人工整理 |
| 人 | 产品经理、BA、SA 并未真正拥抱 AI | 没有选择,必须转变态度 |
我用一张成熟度阶梯来定位目标:L0 纯手工、L1 辅助编程、L2 部分自动化、L3 有条件自动化、L4 高度自动化、L5 完全自动化。当下要争取的,是让需求过程达到 L3——AI 承接操作型工作,人负责关键判断。而 L3 不是靠单点工具就能拿到的,它需要工具、流程、组织、知识、人这五个维度同时动。
🎯 二、机理:为什么传统 SDD 只解决了「最内环」
这是整场分享里我最想讲清楚的一个点。
一个业务组织的运转,其实是三层嵌套的循环:
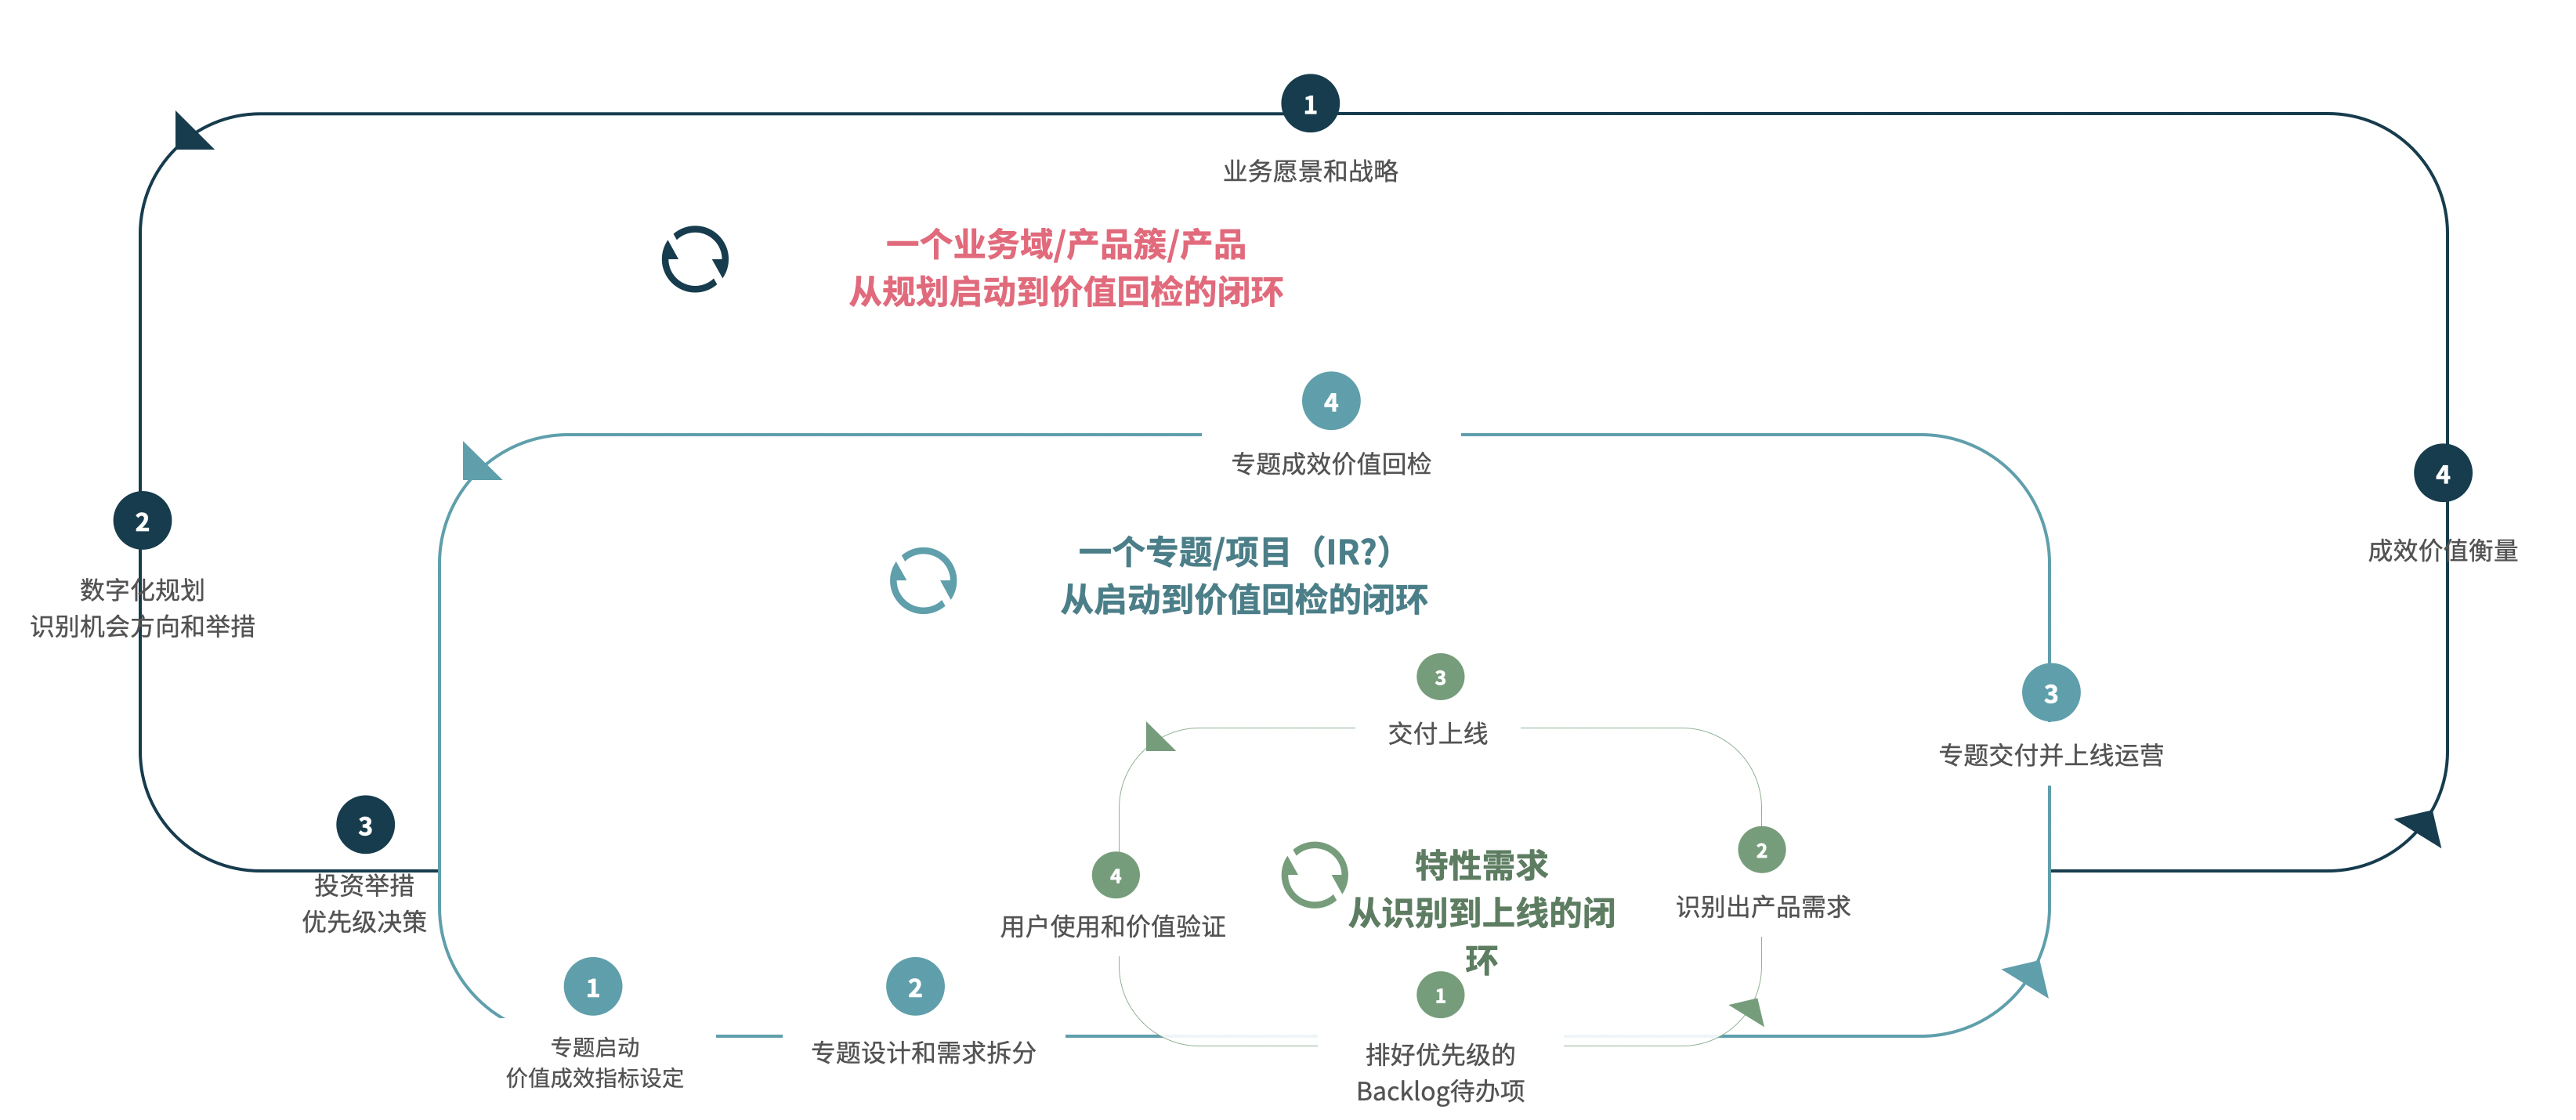
- 最外层:一个业务域/产品族,从规划启动到价值回检;
- 中间层:一个专题/项目,从启动到价值回检;
- 最内层:特性需求,从识别到上线。
以 OpenSpec 为代表的规格驱动开发(SDD)实践,解决的是最内层。它的起点是一个「变更(Change)」——也就是说,一个提案的起点,是设计方案已经确定、代码改哪里怎么改、解决什么业务问题都已经确定。它跑通的是一条很干净的单 Change 管线:
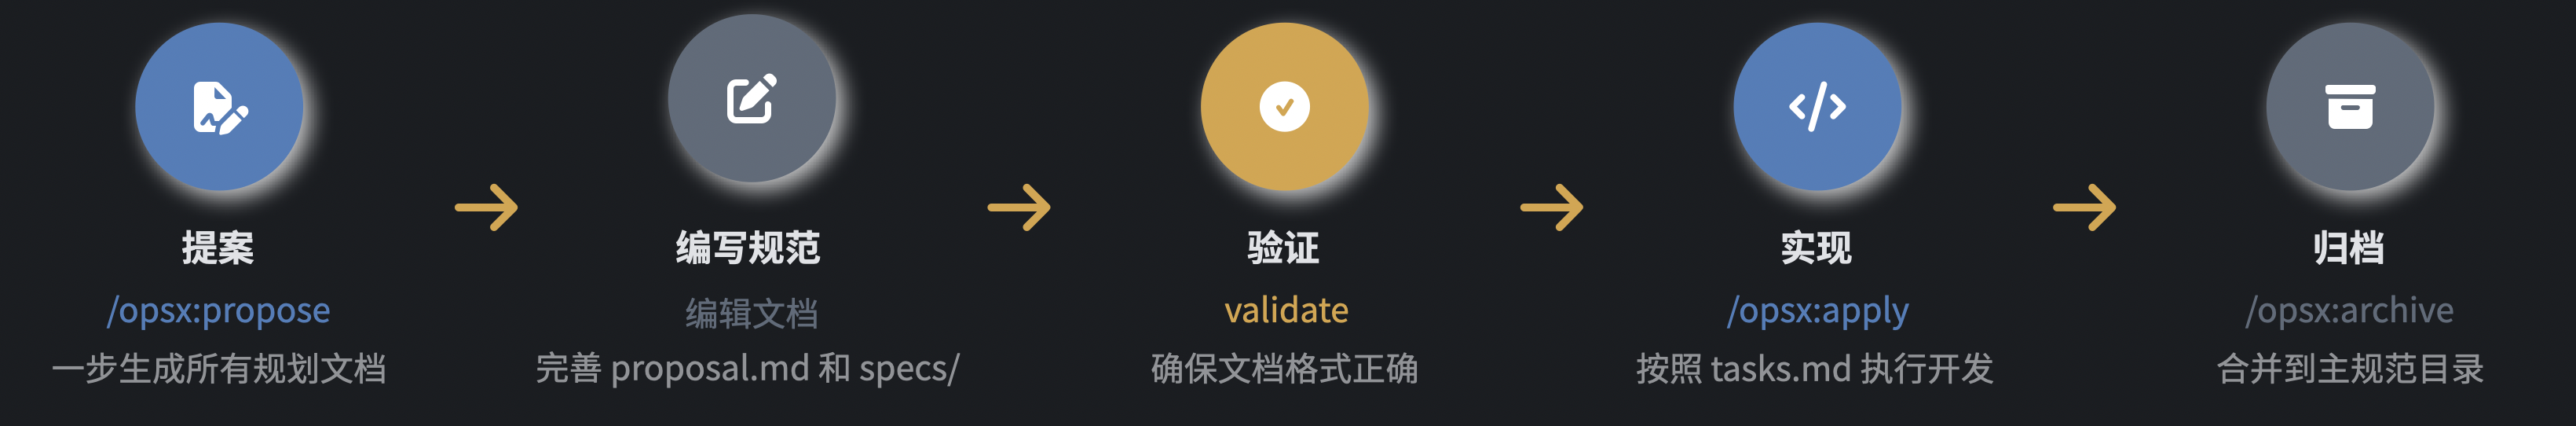
提案 /opsx:propose → 编写规范 → 验证 → 实现 /opsx:apply → 归档 /opsx:archive。
这条管线本身没有问题,它把「意图 → 规格 → 代码 → 归档」跑得很扎实。问题在于它的左边没有东西:从业务想法到可分析的需求这一段外环,仍然以人工为主,工具缺位、流程固化、知识不沉淀。
于是就有了这次分享真正要回答的问题:怎么让 AI 把外环也加速起来,让需求过程同样达到 L3/L4? 答案不是推翻 SDD,而是把它从最内环往外扩展——这也是「OpenSpec-practice」这个开源脚手架想要验证的事情。
🧩 三、破局的前提:让需求产出能被 AI 消费
在谈脚手架之前,有一个前提性的思维转变绕不过去:需求端的产出,要以兼顾 AI 消费为原则。 我的判断是:绝大多数需求产出,都可以结构化,也可以 HTML 化。
具体落到三个动作上:
- 能结构化的都结构化。 叙述性的 PRD 对 AI 不友好——需求点不条目化、验收口径不明确、变更与决策难以审计。把需求拆成可分类、可分层、可机读的结构,是让 AI 能接手的前提。
- 用统一的 Skills 和模板约束产出。 让规划与需求产出规范化、一致化,格式上采用 Markdown/HTML,兼顾人和 AI 两种读者。
- 所有需求产出迁移到代码仓。 从 Wiki、办公系统、团队文件夹搬进代码仓,用 Markdown、Yaml、HTML 和代码同一版本管理。这样做有三个直接好处:更容易引用业务上下文;更容易和「代码里的知识」交叉验证;更利于借助 AI 自动同步更新。
道理不难,但落地有门槛,而且门槛主要卡在两件事上:
| 能力 | 上手成本 | 落地难点 | 应对办法 |
|---|---|---|---|
| Skills | 约 2 小时 | 不是会不会用,而是每次都这么用——养成习惯、坚持规范 | 组织纪律 + 持续的 peer review 共学 |
| Git | 约 2 小时 | 单人会用不等于多人可管,复杂大项目中的版本管理 | 把需求相关 docs 拆到独立 repo,做成 submodule 挂到项目主仓,顺带做权限隔离 |
这两个门槛值得单独强调:工具的学习成本其实很低,真正的成本在习惯与协作纪律上。
🪜 四、从 L1 到 L3:按团队分型选脚手架
把 SDD 扩展到产品端到端,最容易犯的错是「一刀切」——用一个重流程去套所有团队。实践中不同域的团队差异其实很大:决策链路有轻有重,协作界面从 1 个角色到 5+ 角色不等,规则密度、影响面、生命周期也各不相同。
所以我倾向于从最小可用开始,按团队分型、逐步扩展,对应三种形态:
| 维度 | L1 极简交付 | L2 轻量产品 | L3 业务产品 |
|---|---|---|---|
| 团队 | 小型工具团队 | 单业务产品团队 | 跨部门业务产品团队 |
| 决策链路 | PM 一人可定 | 业务与产品融合 | 分离 · 多方会签 |
| 协作界面 | 1–2 个角色 | 3–4 个角色 | 5+ 角色 · 跨部门 |
| 影响面 | 内部工具,可回滚 | 单条业务线用户 | 资金 · 合规 · 多业务线 |
| 规则密度 | 技术属性强,规则简单 | 中等,有业务编排 | 密集 · 跨域 · 强合规 |
| 生命周期 | 一次性,用完即弃 | 持续迭代 6–18 个月 | 长周期,跨版本复用 |
| 企业示例 | 平台团队自研的 CI/CD 脚手架与内部 CLI、数据团队自助取数工具、AI 团队 Prompt 评测台 | 电商 App 的会员体系与营销模块、消费金融 App 的信贷申请流程、在线教育的课程学习打卡 | 车企的整车订单与交付履约系统、银行对公信贷与风控、制造企业的供应链计划中台 |
模式一:L1 极简交付,先跑通最小管线
只做一件事:把「意图 → 需求 → 规格 → 代码」这条原始管线跑通,零治理、最轻。
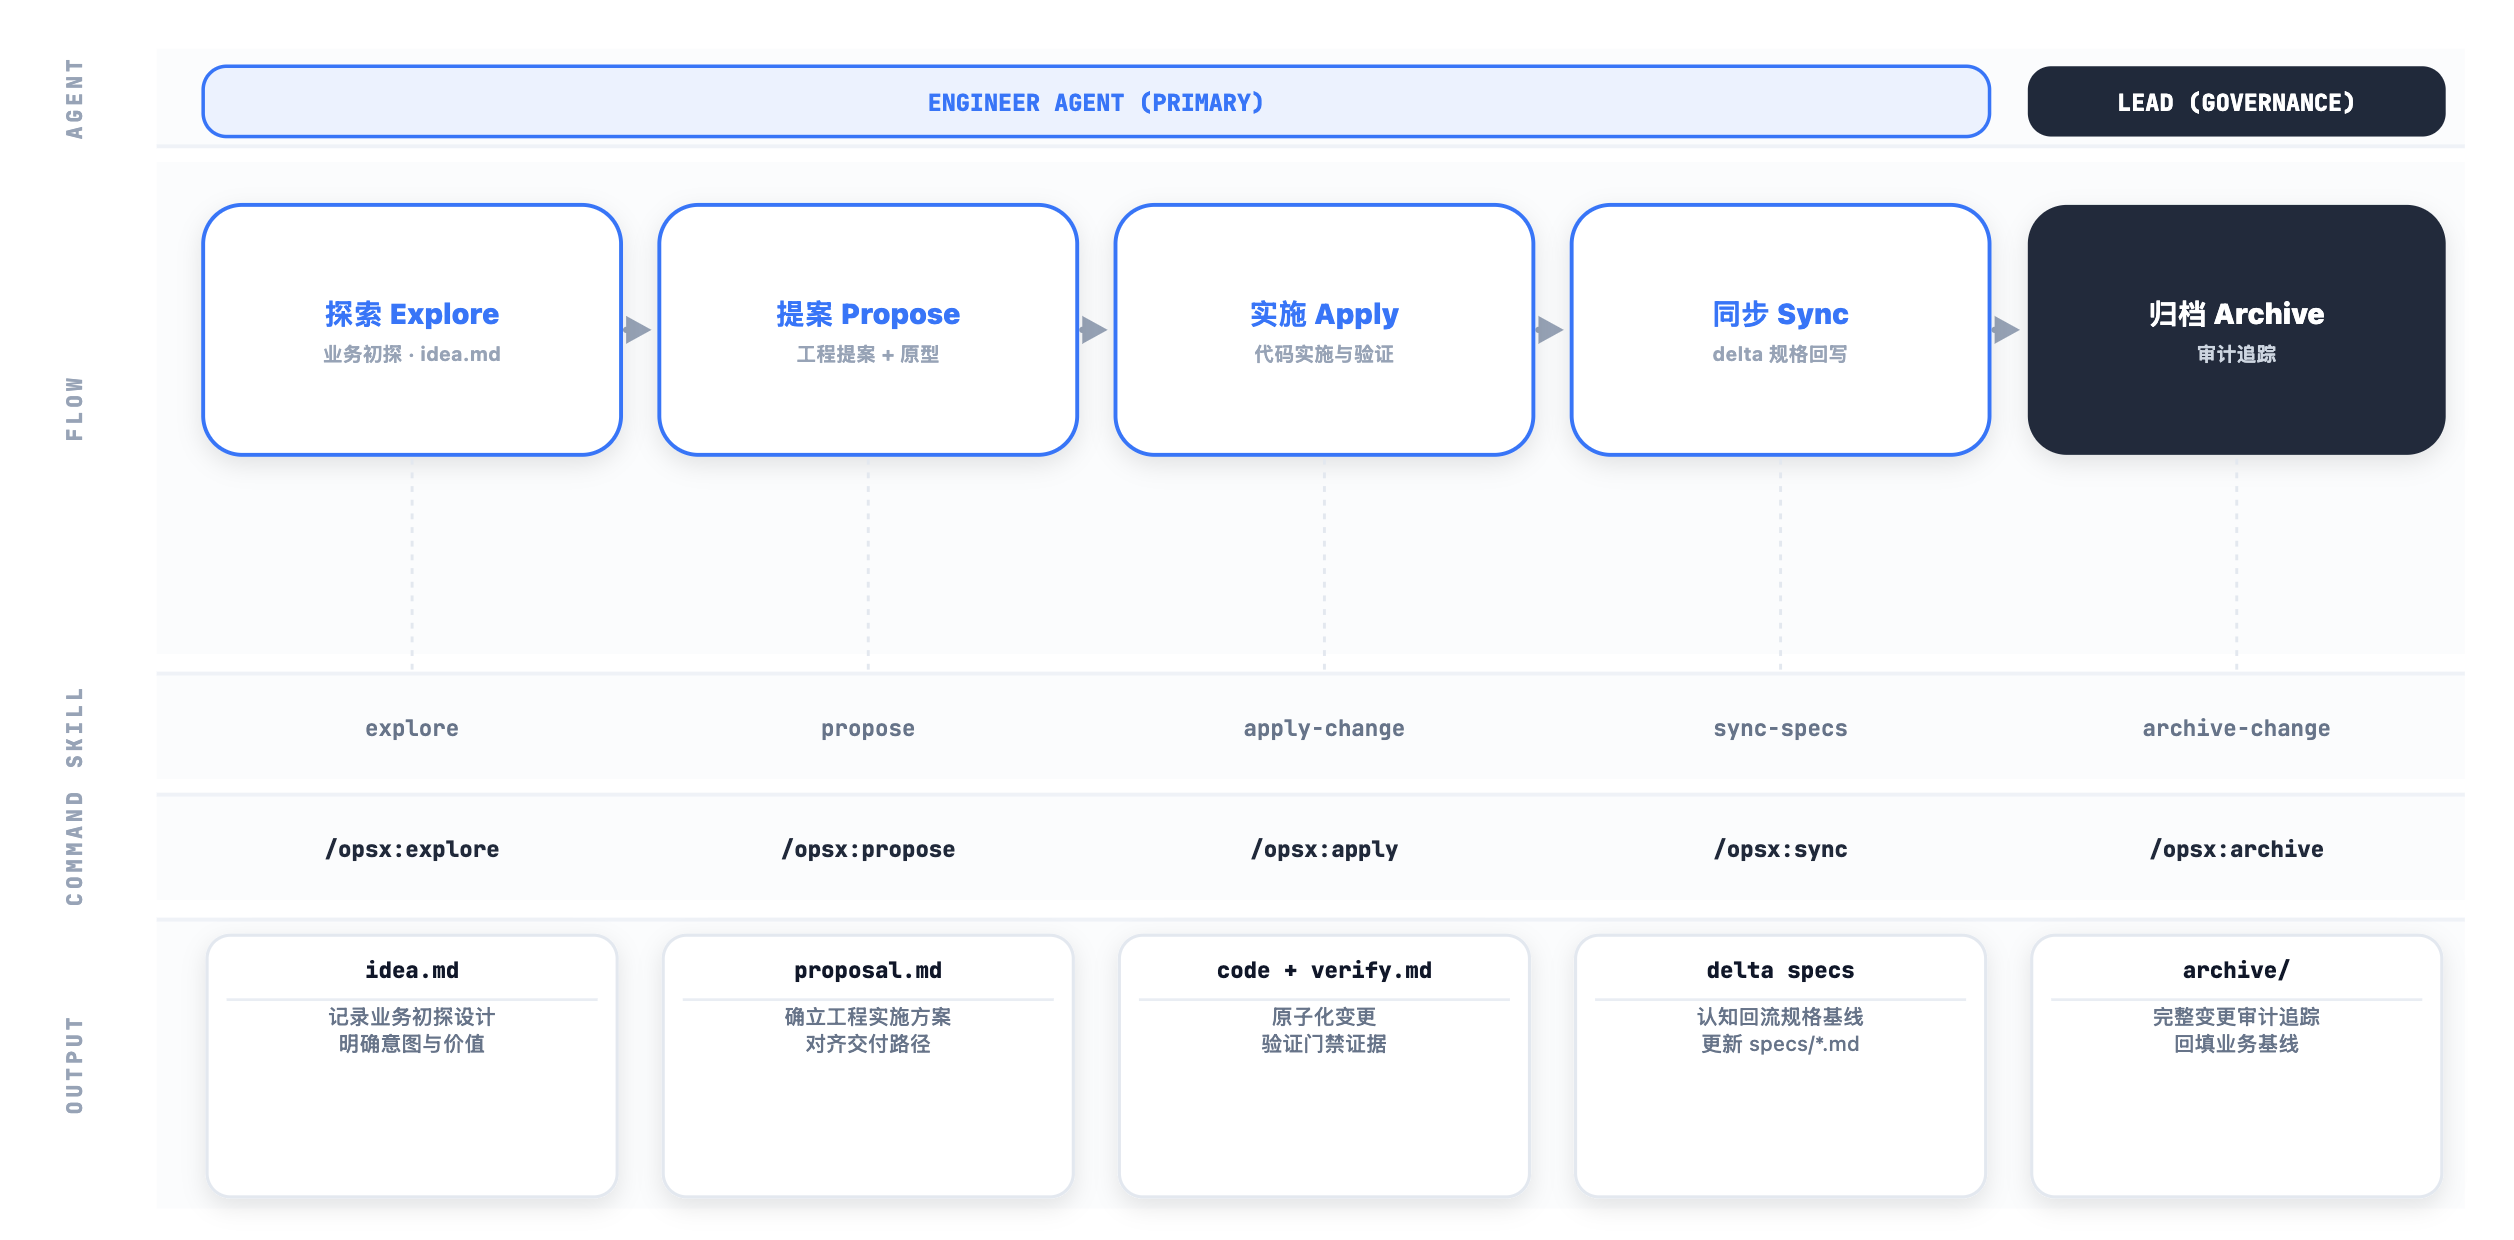
工程侧由 Engineer Agent 主力承担,Lead 负责治理与归档,对应 Explore → Propose → Apply → Sync → Archive 五个环节。
模式二:L2 轻量产品,基线护栏 + 多 Story 循环
当团队开始服务一条真实的业务线,就需要引入「规划基线」与「业务基线」作为护栏——基线只放必选,护栏兜住方向,多条 Story 在护栏内循环拆解、逐条冻结。
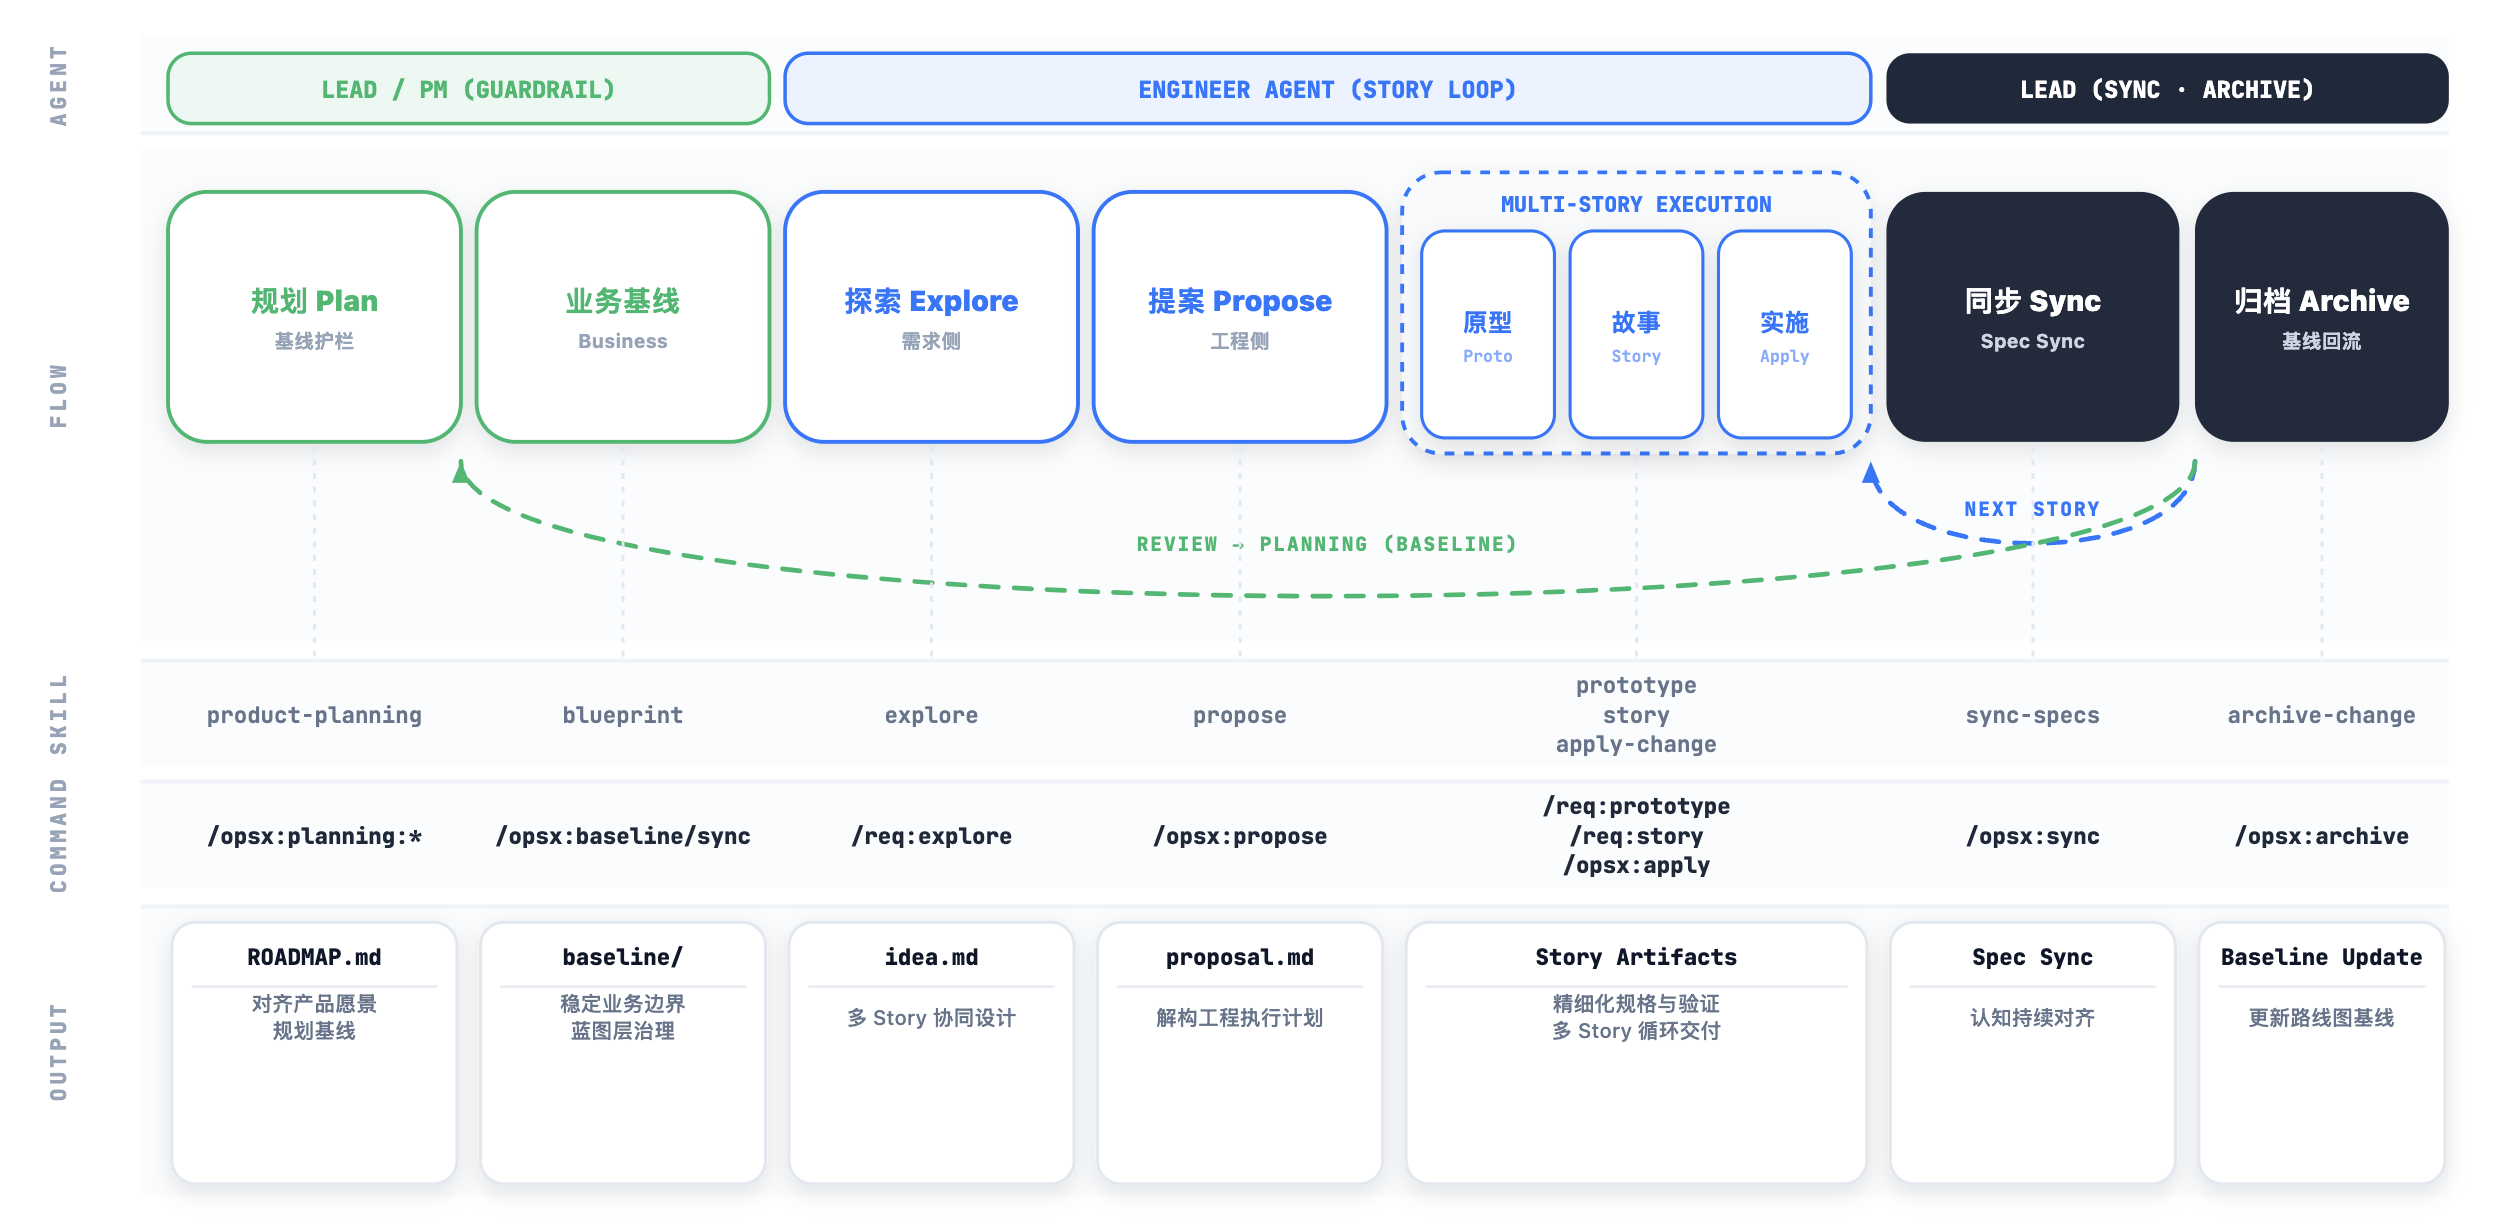
Lead/PM 负责规划与业务基线,Engineer Agent 在 Story Loop 里做「原型 → 故事 → 实施」,完成一轮后按 Story 回到探索,直到整个变更收口,再进入 Spec Sync 与归档。
模式三:L3 复杂业务产品,双轨解耦与分层同步
到了跨部门、强合规、多角色协同的场景,就必须做需求侧与交付侧的深度解耦。
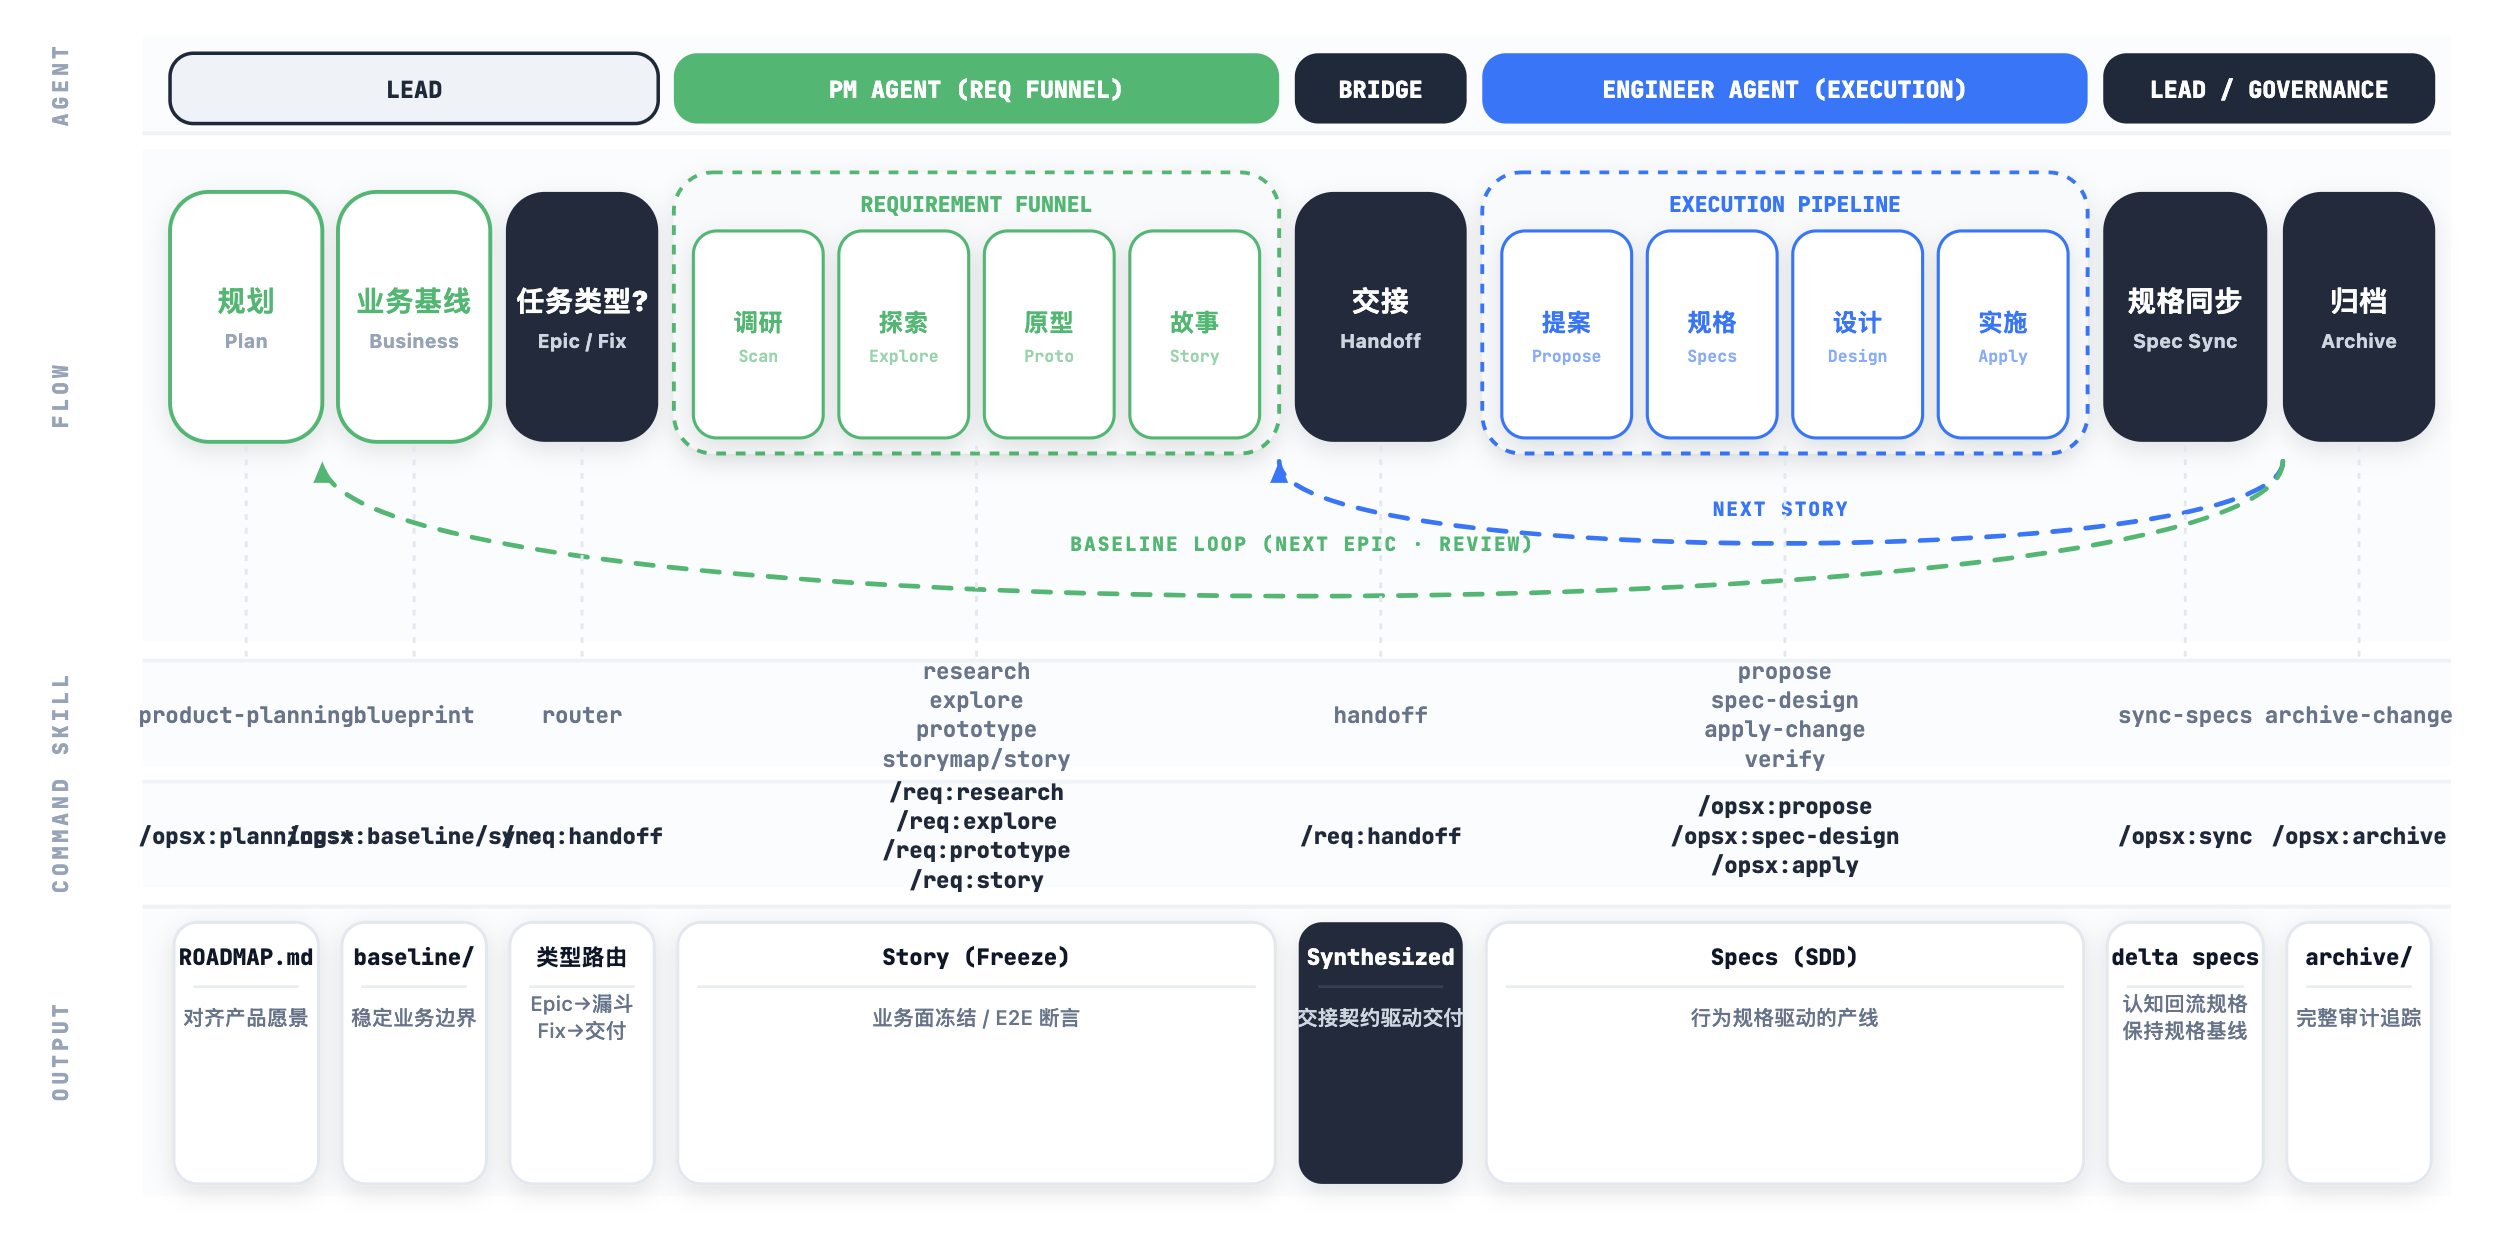
- 需求侧(PM Agent 主导):走需求漏斗——调研(Scan)→ 探索(Explore)→ 原型(Proto)→ 故事(Story);
- 中间由 Lead 做交接(Handoff):把已冻结的 Story 合成开发侧的 proposal;
- 交付侧(Engineer Agent 主导):走执行管线——提案(Propose)→ 规格(Specs)→ 设计(Design)→ 实施(Apply);
- 治理侧(Lead/Governance):规格同步(Spec Sync)与归档(Archive)。
为什么要把两侧拆开?最直接的原因是变化速率不同:业务语义变化慢,实现细节变化快。如果放进同一个变更目录,任何一次实现调整都会污染业务评审记录。拆开之后,业务面一旦冻结就能触发后续链路,交付侧的技术演进也不会反复冲击已经冻结的业务语义。
这里有一条重要的适用范围路由:
大块 Epic 走需求侧漏斗,交接后进交付侧; Bug Fix / Tech Debt / 简单功能修改 直走交付侧,从
/opsx:propose起,不进需求侧。
工程化的本质,我的理解是有选择的深度,而不是盲目的全面。简单需求直走交付,复杂需求深度受控,才能避免「小需求排队等大流程」。
⚙️ 五、复杂业务产品的四个关键机制
L3 模式之所以能跑起来,靠的不是更复杂的文档,而是四个机制。它们也是这套脚手架里我认为最值得单独拎出来讲的部分。
机制一:需求漏斗六步,把「写文档」变成「过工序」
需求被当成一个整体项目、采用「写完 → 评审 → 确认」的串行模式时,任何一个细节不确定都会阻塞整篇文档签发。需求漏斗换了个组织方式:把需求加工拆成六个有明确产出与准入准出的工序。
| 环节 | Skill | 产物 | 要点 |
|---|---|---|---|
| 需求调研 | research | research.md | 只收集不转化:背景/干系人/访谈原始记录/约束/疑问/结论;先调研,再据结果识别 Epic 并创建目录 |
| 探索 | explore | idea.md | 把调研转化为产品设计思路:To-Be Process / To-Be Journey / 候选 Capabilities |
| 原型(Epic 整体) | prototype | prototypes/*.html | 拆分前对 Epic 整体做一次;复杂业务可走可工作原型;HITL 确认 |
| 需求拆分 | storymap | storymap.md | 覆盖对账(强制):Epic 每个承诺项必须有 Story 承接 |
| Story 交付 | story | stories/<story-key>/story.md | 业务面唯一冻结交付物:用户场景/规则表/E2E 验收/治理映射 |
| 交接 | handoff | 合成 proposal.md | 登记 story-list.json、回填 STATUS.md,交付侧起步 |
这六步里,有三条纪律是硬要求:
- 只收集不转化。 调研阶段强迫「只记录原始访谈、事实与数据」,防止过早进入方案设计导致认知闭塞。事实和解读要分开。
- 原型是认知对齐的载体,不是高保真设计稿。 它的目的是实现最低成本的共识,让分歧发生在交互演示里,而不是上线后。而且原型在拆分前对 Epic 整体做一次,受 HITL 锁定——没有已确认原型,不得拆分、不得交接。
- 覆盖对账。 拆分环节强制把「原始承诺项」与「交付 Story」逐一关联,既防漏项(承诺未承接),也防范围蔓延(承接无承诺)。在示例里,账户体系这条线最终是 14/14 全部对账。
漏斗真正在做的事,是逐级提高信息的确定性:从「事实」(research)到「解读」(explore),到「具象」(prototype),到「边界」(storymap),再到「契约」(story)。每一级都有明确的产物和完成定义,因此任何一步被打断,损失是单步的,不是整篇的。
还有一个反直觉但很关键的取舍:最小冻结单元是 Story,而不是 Epic。 一个 Story 的业务规则一旦冻结,立即交接进入开发侧,后续 Story 继续在需求侧加工。冻结单位越小,等待链条越短,需求与交付两条管线才真正并行起来。
机制二:反向沉淀,从「原型确认」到「可追溯的规格」
原型确认之后,它的价值不应该止于「看过、同意」。这套实践强调一个反向沉淀链路:
① 原型确认 → ② 提取规则 → ③ 编写 Specs → ④ 进入代码仓。
- 从确认过的交互里提炼出规则表,例如
R-CUS-001~005:归属、倒序、状态、轨迹、详情; - 把显式排除项固化为边界:不做 C 端取消、不做多用户切换、不做分页;
- 规则逐条转成 Gherkin,例如「列表渲染」标
@e2e、「他人订单不可见」标@api; - Specs 归到
openspec/specs/下,与前端同仓、同版本演进。
一句话:画面 + 显式边界 = 范围契约。 原型里的每一次点击,都能在规则表里找到一行,在 spec 里找到一个 Scenario。原型确认什么,契约就冻结什么,测试就验证什么。
机制三:分层同步,Spec 逐变更新鲜,Baseline 按 Epic 整洁
需求产出要「活」,就必须解决「文档即谎言」的老问题。这里用了一套分层同步机制,而不是把所有东西都实时合并。
| 层级 | 触发时机 | 作用 |
|---|---|---|
| Spec Sync(change 级) | 每个变更归档前合并 delta specs | 保证下一个 Story 基于最新规格 |
| Baseline Sync(Epic 级) | Epic 全部 Story 归档后统一回流 | 到点做 Sync Assessment,无变化也显式记录 No-op |
基线资产本身也有明确的治理边界:
| 基线资产 | 治理什么 | 何时更新 |
|---|---|---|
domain_model | 业务边界 · BC→能力映射 · 不变量 | 边界/映射变化时 |
business_process | L1/L2/L3 流程节点(验收引用源) | 流程节点增删改 |
service_blueprint | 跨角色泳道 · 旅程阶段 · 能力状态 | 能力分布变化时 |
ROADMAP / PRODUCT | 排期 · 阶段边界 · 产品定位 | 阶段收尾 · 月度滚动 |
为什么不能合成一次同步?真实案例是「应收」这个 Epic:它下面 9 个 change 各自在归档前做 Spec Sync;聚合为 Epic 之后,只做一次 Baseline Sync——domain_model 新增聚合与实体、service_blueprint 新增应收阶段、ROADMAP 标注完成。
结论很清楚:Spec 需要逐变更新鲜,Baseline 需要 Epic 级整洁;两者的节奏不同,所以不能合并。
机制四:用指标让需求阻塞显形
需求阻塞很少是突然发生的,更多时候是没有指标让它显形。这套实践把四个指标从 STATUS.md 和 story-list.json 里自动读出来,随交付看板一起刷新:
| 指标 | 说明 | 载体 |
|---|---|---|
| 漏斗 WIP(在制 Story 数) | 限制同时在漏斗中的 Epic/Story 数量,超上限即显式过载 | STATUS.md 的 Story 交付状态表 |
| Story Lead Time(想法 → handoff) | 按周跟踪,持续变长说明漏斗某一步堵了(通常是 HITL 等待) | STATUS.md 的阶段状态表 |
| HITL 一次通过率 | 打回次数 / 提交次数,衡量操作性产出质量;过低说明完成定义不够清晰 | 各阶段 skill 自动更新 STATUS.md |
| 覆盖对账漏项数 | 每次 storymap 必须为 0,是需求侧唯一可自动检查的硬指标 | story-list.json 跨 change 单轨队列 |
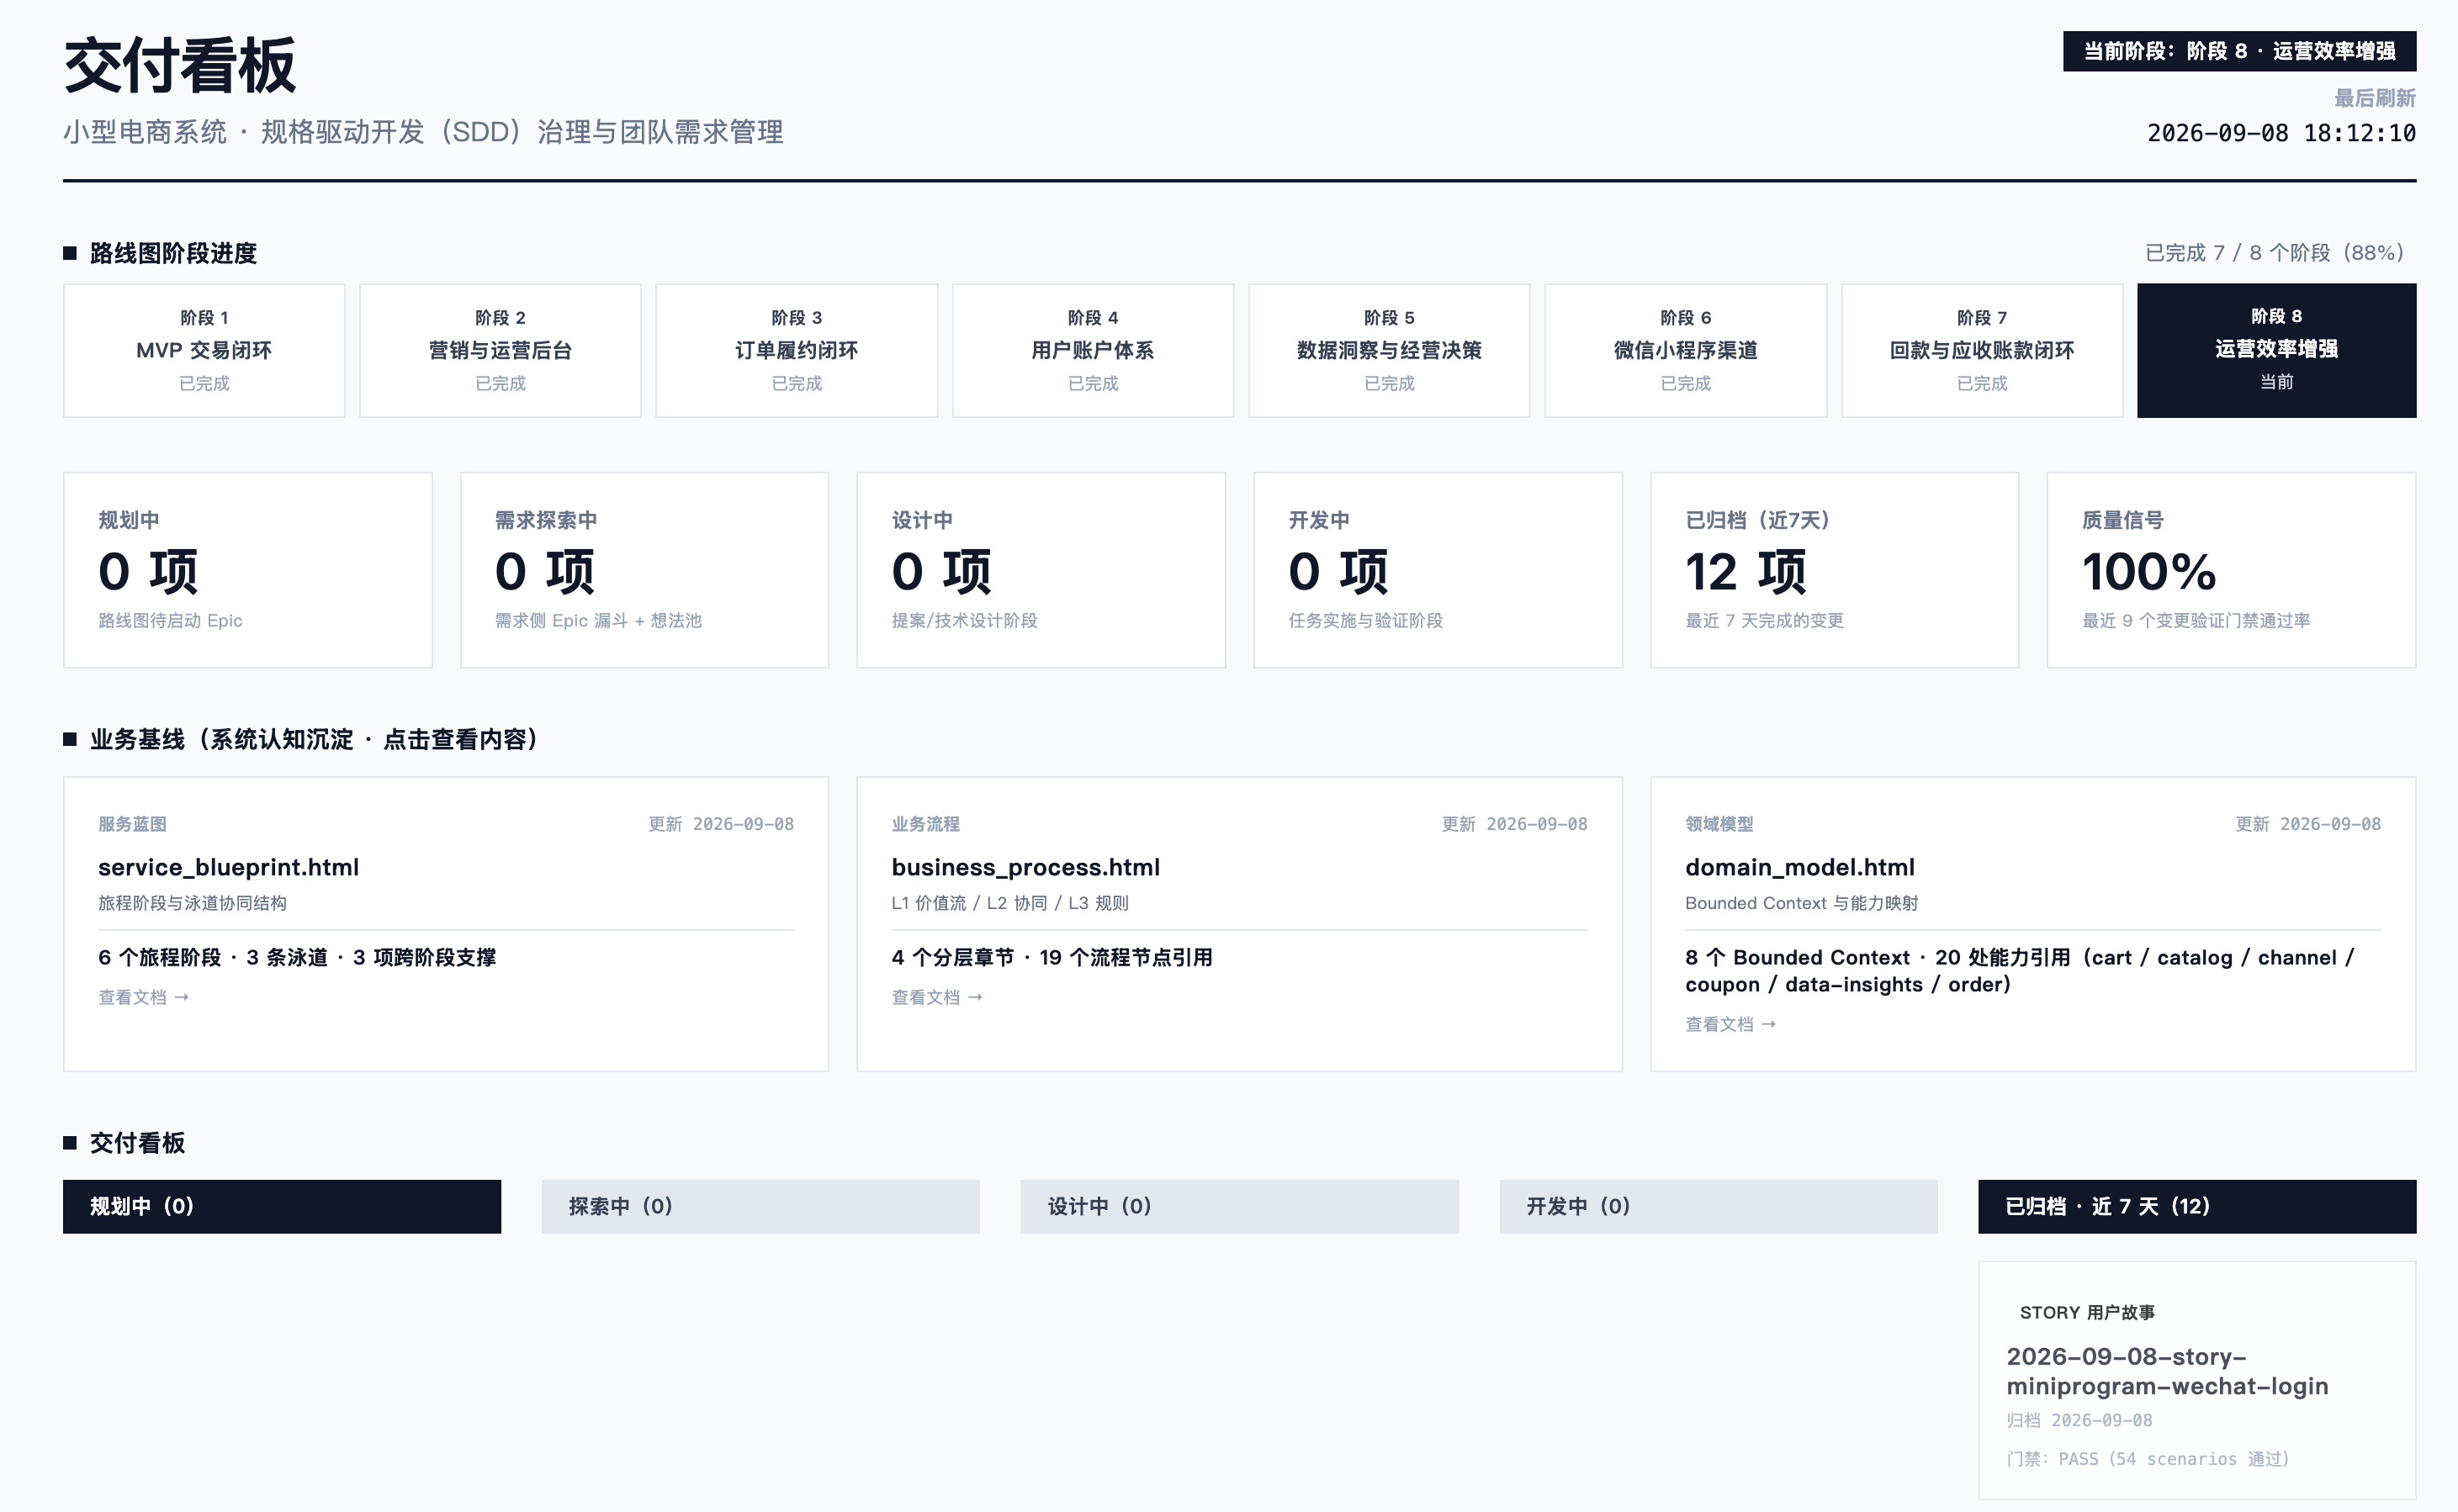
看板本身不复杂,但它把「在制数、等待时长、返工率、漏项」这些原本模糊的感受,变成了可以被管理的东西。能被测量的阻塞,才能被解决。
🧑💻 六、人的转变:从「写文档的人」到「设计结构的人」
工具和流程都到位之后,最难的部分其实还是人。在分享的最后,我把对 PM / BA / SA 的新要求归纳为三重转变:
| 旧的工作方式 | 新的工作方式 |
|---|---|
| 写一篇 PRD | 设计结构:不再只产出文档,而是设计指导 AI 的工作过程、输出模板,并结合经验反馈持续调整 |
| 交付即结束 | 持续看护资产:交付不再是终点,持续看护资产成为日常工作的一部分,可能占据 30–40% 的精力 |
| 抛给开发 | 闭环协同:与 AI、开发、测试在 Specs 资产上协作,而不是在 IM 里对齐 |
把事务性、操作性的任务交给 AI,人专注在洞察、判断和决策上——需求工程师的角色,会越来越像产品架构师:像设计代码结构一样,设计输入结构、治理规则与反馈回路。
至于规模化落地,我的建议是三个阶段,不要一步到位:
- 单点跑通:选 1 个真实但边界清晰的 Epic,用 L1 极简交付跑完整流程,验证「需求不返工、输出稳定」;
- 沉淀基线:在 1 个业务域内让 Baseline Sync 真正跑起来,
STATUS.md/story-list.json成为单一状态源,让术语、Specs、基线能被下一个 Epic 复用; - 规模化:多域、多团队时按 L1/L2/L3 分型适配流程,从「人盯」转向「看板盯」。
几条落地 Tips:
- 先有门禁,再谈自动化——HITL 检查点是 L3 的地基;
- 指标先于自治——没有度量就没有 Human on the Loop;
- 防腐蚀——基线无变化也要记录理由;
- 组织纪律 + peer review——工具 2 小时学会,习惯靠组织;
- 按类型选路径——简单直走、复杂深控,不搞一刀切。
最后一句经验:转型是一个过程,要给团队 3–6 个月的时间。
✍️ 写在最后
这套脚手架我已经开源了:OpenSpec-practice(github.com/jkang/openspec-example)。里面按时间保留了三代实现,可以用 tag 逐代对照演进:
v1.0-minimal-delivery(极简交付):只跑通单 Change 的完整管线;v2.0-lightweight-sdd(轻量版):引入规划层与业务基线,支持多 Story 循环;v3.0-full-sdd(完整版):需求侧/交付侧两级解耦、需求工程链路、分层同步与多角色协同。
如果你也在做企业 AI 落地,这几篇可以一起看:从文档驱动到原型驱动、落地企业级 AI 应用,产品经理要会的 20 件事、企业落地 AI Skill 的 12 个疑问,以及 为什么说「本体设计」是企业级 Agent 的第一道护栏。
回到最初的问题:编码自动化之后,需求为什么成了新瓶颈?我的观察是——瓶颈从来不会凭空消失,它只会沿着交付链路往上游转移。 当实现不再是约束,需求过程的确定性,就成了下一段需要被工程化的路。
你们团队现在的看板上,压力位是在「开发中」还是在「需求分析中」?欢迎留言聊聊。
#AI产品经理 #SDD #规格驱动开发 #需求工程 #OpenSpec #AI4SE